✪刘禾|美国哥伦比亚大学
【导读】人工智能发展至今,对社会造成的深度影响恐怕远超人们的预期。无论是科技巨头在前沿模型上的竞赛,还是普通人工作生活中体会到的便利,人工智能的技术能力已毋庸多言。
但人工智能并非从天而降的“纯净”技术。它的训练数据建立在什么基础上,又是谁通过隐形劳动支撑着模型的调试迭代,都值得我们深究。通过追溯美国科技巨头持续二十余年的“数字圈地运动”,本文作者分析了人工智能如何深度嵌入当代资本主义的运作逻辑。依靠法律的保护伞,科技资本大规模收集数据,并借助不断扩张的版权保护体系,赋予自身垄断式的使用权力,最终将人类数千年来积累的公共知识私有化为可出售的数字资源,并从中攫取超额利润。在AI模型训练的全过程中,全球南方的廉价劳动力提供的数据清洗、图像标注等关键工作,亦从不在人工智能的叙事中出现。包括普通用户的日常行为在内,大量不可见的资源和劳动,无声无息地被纳入了数字垄断资本主义的谋利链条。
作者警告,当前的硅谷AI巨头已成为在数字领域坐收地租的“食利者”。金融资本与数字知识垄断的紧密结合达到了新的高峰,如果继续延续现有的发展模式,我们极有可能走向知识垄断资本主义与科技巨头的奴役之路。能否在历史的岔路口做出正确的选择,并不取决于技术本身,而更需要人类共同的政治决心和贯彻行动的意志。如今,世界范围内保护数字知识公地、坚持开源模型、促进全球协作的呼声愈发高涨,各国政府、各级研究机构与社会组织在这方面的积极探索,为人类指出了走向AI社会主义的另一条道路:只有坚持模型开源、算力共享、语料共建、标准互通,AI才有可能成为真正解放生产力的工具,而非加剧不平等的枷锁。
本文原载于《文化纵横》2026年10月刊,仅代表作者观点,供读者参考。
走向AI社会主义
22年前,我亲历了一场数字“圈地”运动。这是有史以来最大规模的数字圈地,它的原发地不在别的地方,就在美国密歇根大学安娜堡的校区内。
2004 年,我碰巧在那里任职,教学之余,开始撰写《弗洛伊德机器人》的书稿。早春,安娜堡的冰雪开始融化的时节,我听说谷歌公司派人到我们大学,提出了一个宏伟的计划。他们要和学校图书馆签约,准备花六年的时间,把密歇根大学图书馆里的七百万册藏书全部数字化。根据这个合约,数字化后的扫描副本,一份归谷歌,一份留在密歇根大学图书馆。在当时,没有人意识到,这就是全球图书馆数字化的开端,而它就发生在我任教的密歇根大学。
谷歌公司给密歇根大学提出的口号是“知识民主化”。他们说,大学图书馆的藏书不能只为少数知识精英服务,还必须向所有的普通大众开放,而数字化是最佳的民主途径。这样一来,谷歌就能和大学共赢,与民众共享数字化图书馆。这个理由听起来简直无懈可击,大学中的很多教授,包括我自己,都为谷歌提出的知识民主化感到兴奋,也为大学向世界开放美国的数字图书馆抱有热切的期望。当时唯一没想到的是,那些被谷歌公司数字化的图书可能会经历一个完全不同的命运。
时隔二十年之后,我们才真正明白,那是一个怎样的命运。迄今为止,所有被数字化的图书都充当了硅谷 AI 公司训练商用人工智能大语言模型的数据。与此同时,大学图书馆、公共图书馆以及很多为谷歌公司无偿提供数据资料的机构和团体,却被谷歌和他们签订的法律条文所捆绑,无法自主使用谷歌提供给图书馆的数字副本。[1]
▍ 一场惊心动魄的数字圈地
历史经常有惊人的相似。
从 15 世纪到 19 世纪初,英国贵族和新兴资产阶级用篱笆和围墙把公共牧场、农田和公用土地逐步圈为私有,完成了英国大规模的“圈地运动”。这场运动把农民世代共享的土地资源转化为少数人的私有财产,奠定了资本主义原始积累的基础。几百年后的今天,一场更为隐蔽、规模更为庞大的圈地运动在数字领域里发动,已经殃及全人类的知识财富。硅谷科技巨头们把人类共享的知识公地(knowledge commons)——图书馆、互联网、开源代码、学术研究等——转化为人工智能模型的私有财产,再通过商业 API 标上价码,逐一出售给社会。
这场数字圈地运动的核心逻辑与历史上的圈地运动十分相似:公共资源被无偿占有,或者被低价获取,这些资源在经过技术加工之后,再以私有财产的方式进入市场。唯一不同的是,今天所谓的“公地”是人类几千年以来积累的全部知识财富;所谓“篱笆和围墙”是知识产权法和商业秘密法;而今天的“牧羊人”则是那些训练大型语言模型的算法工程师和 AI 公司董事会的老板。
但是,任何有说服力的分析都不能只停留在类比和隐喻上,我使用的“圈地”类比也不例外。最近,国外围绕所谓“技术封建主义”的辩论就是一例。我认为,拿欧洲封建王国的概念去解释今天的知识垄断资本主义是极其有限和误导的。[2] 无论在技术上,还是在哲学上,甚至在词源本义上,“技术封建主义”的类比,根本无法捕捉到知识垄断资本主义的当代形态及其太空规模,比如“轨道数据中心”的策划和建设。
因此,我们亟须了解一些最基本的事实,以及事实与事实之间的逻辑关系,努力摆脱围绕在 AI 四周的谎言和众生喧哗——这些谎言最简单的方式就是吓唬人,比如宣布机器即将超越人类等等;不然的话,我们将无法提出真正值得思考的重大问题。我在这里要提的问题是:公共数字资源是如何被转化为私有财产的?什么叫知识垄断资本主义?我们如何保护数字知识公地,如何坚持开源模型的公共性,并促进全球协作和知识共享?如果 AI 社会主义是最好的选择,那么,我们应该如何面对实现 AI 社会主义的前景和困难?

2004 年,密歇根大学与谷歌签署数字合约并非孤立事件。
同一年,谷歌还与哈佛大学、斯坦福大学、牛津大学(英国)和纽约公共图书馆都签了约,启动了野心勃勃的“谷歌图书馆计划”。密歇根大学是他们选定的首个测试站点,因为谷歌公司的创始人之一拉里·佩奇,是密歇根大学的校友。校方与谷歌从 2002 年就开始洽谈,对方的承诺是,所有扫描成本由谷歌承担,密歇根大学无须支付任何费用,并能获得每一本图书的数字副本。对于这所公立大学而言,这似乎是一笔无法拒绝的交易,用零成本获得整个馆藏的数字版本,何乐而不为呢?两年后,我们听说加州大学的图书馆系统、弗吉尼亚大学、威斯康星大学以及美国国会图书馆等机构也都陆续加入谷歌的数字化工程。
谷歌公司在密歇根大学的试点扫描工程于 2004 年 4 月开始。我们当时非常关注这件事,但过了不久,就开始发现事情有些蹊跷。扫描是怎样进行的?我们一无所知,因为扫描设施从来不对公众开放,谷歌人员的往来也神出鬼没,一切似乎都在秘密中进行。扫描后的数字副本将被用于什么目的?图书馆的数字副本将受到什么样的限制?等等。所有这些疑点都被“知识民主化”的口号所掩盖。受到好奇心的驱使,我和几位同事开始四处打听,想知道谷歌和校方签署的法律条款都有哪些具体的内容。我们得到的回答是,校方签署的合约是商业机密,不向师生公开。所以,我们尽管身处图书馆数字化的原发地,但完全无法了解到扫描工作的细节,也不清楚这些数据将如何被他们存储和使用。
两年过后,我离开安娜堡去了纽约,就没有积极跟踪此事的发展。很意外的是,真相通过迂回的方式进入了我的视野。2011 年,英国有一个民间组织叫“开放权利群体”(Open Rights Group),他们通过《信息自由法》获得了大英图书馆与谷歌公司签署的类似协议。这份协议在网上公开后,我才知道谷歌的协议对大英图书馆使用自己的数字副本施加了严格限制,比如它禁止大英图书馆数字副本的商业使用、重新分发或者自动下载,而同时赋予谷歌自己以广泛的商业自由,包括授权、出售、文本发掘、搜索引擎训练。我因此推测,谷歌在此之前与美国各个大学签署的协议,内容应该大同小异。谷歌公司对图书馆的数字副本严加限制,但给自己广泛的商业自由。
这就揭开了数字圈地的部分真相:公共机构在免费数字化的诱惑下,把人类知识的原始材料拱手让渡给私营公司,而换来的数字副本却戴上了镣铐,因为图书馆不能自主使用自己获得的数据扫描副本,谷歌则可以将其用于商业目的。
故事发展到这里,还只是一个序曲。
2004 年底,谷歌公司跑到法兰克福书展,公开宣布他们正式启动了“谷歌图书馆项目”。这个消息一经公布,美国著作家协会(Authors Guild)和美国出版商协会(Association of American Publishers)表示不安,开始研究对策。因为谷歌项目针对的不光是版权过期的旧图书,也包括海量版权保护期内的图书。在传统版权法的框架下,任何商业机构若想复制或使用受版权保护的作品,都必须事前取得作者的许可,支付一定的费用。可是,谷歌公司没有通知任何作者,也没支付一分钱的许可费,他们就拿着全本直接扫描了。
美国著作家协会会长尼克·泰勒和执行董事保罗·艾肯向谷歌提出了交涉,要求他们立即停止未经授权的扫描行动,必须“先授权、后扫描”。面对著作家协会和美国出版商协会的巨大压力,谷歌在 2005 年 8 月终于做出回应:可以暂停扫描版权保护期内的图书,给持有版权的作者提供退出的选择,意思是如果某个作者不愿意自己的书被谷歌扫描,必须亲自向谷歌提交“退出”的申请,否则谷歌将恢复扫描。
这种做法激怒了著作家协会,他们认为,谷歌的“退出选择”是把保护版权的责任强行转嫁给著作者,而世界上有数百万名作者,他们根本不可能都收到谷歌的通知,更不要说去填写他们那个烦琐的退出申请表。于是,著作家协会决定采取法律手段,阻止谷歌的侵权行为。2005 年 9 月 20 日,著作家协会在纽约曼哈顿联邦地方法院对谷歌正式发起了集体诉讼,指控谷歌进行“大规模的盗版与版权侵权”,要求法院下达指令阻止谷歌继续扫描,并按法律规定的最高标准进行赔偿。这就是著名的“美国著作家协会诉谷歌公司”(Authors Guild, Inc. v. Google, Inc.)诉讼案。
2013 年,纽约南区联邦地区法院以“合理使用”(fair use)为由,裁定谷歌胜诉。美国著作家协会不服,上诉到联邦第二巡回上诉法院。2015 年,第二巡回上诉法院做出裁定,认为谷歌的图书扫描和搜索使用的文本片段属于“合理使用”,不算侵犯版权。著作家协会依旧不服,继续上诉美国最高法院。2016 年,最高法院驳回美国著作家协会提交的调卷令申请,维持第二巡回上诉法院支持谷歌的判决。这个判决从法律上为大规模的数字圈地扫清了障碍,也为后来 AI 公司的大规模数字圈地铺平了道路。
2026 年春天,我忽然收到来自加州的美国法律行政管理公司的一封邮件,打开一看,内容是 Anthropic 版权集体诉讼案(Bartz v. Anthropic)。信中说:“现就 Anthropic 版权集体诉讼一案通知您,双方已达成和解。该诉讼指控 Anthropic 从两个据称系盗版的在线数据库——Library Genesis(LibGen)和 Pirate Library Mirror(PiLiMi)——下载作品,从而侵犯了受保护的版权。根据目前的和解方案,每部作品可获赔约三千美元……”我很惊讶收到这封信,因为律师团队居然调查到 Anthropic 公司一共盗取了我的七本英文著作。我猜所有被侵权的著作者,包括我在哥伦比亚大学的同事们,都收到了同样的邮件。这家法律行政管理公司在诉讼案的双方达成和解后,发信给每一个版权人,要求他们填一份表,否则将不能参加集体索赔过程。但是,上网填表并不意味着每本书一定能获赔三千美元,原因很简单:在美国打官司,律师才是真正的赢家。[3]
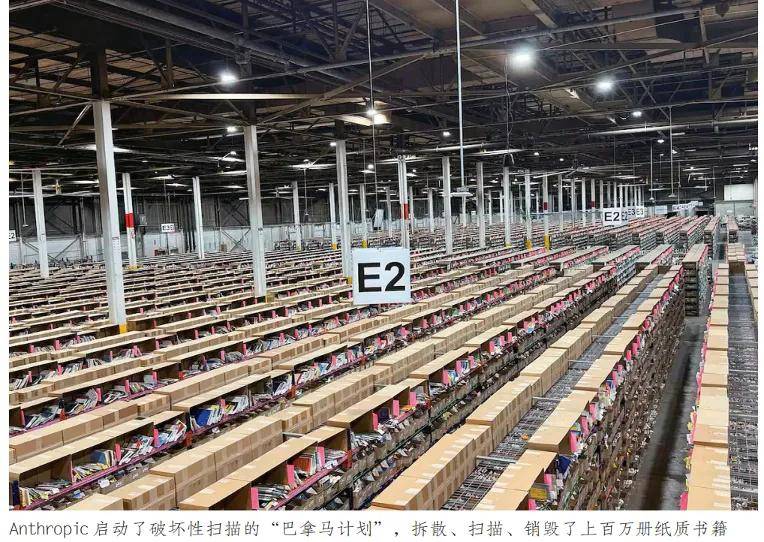
那么,Anthropic 公司的集体诉讼到底是怎么一回事呢?2024 年 8 月,三位作家——安德烈娅·巴尔茨、查尔斯·格雷伯和柯克·华莱士·约翰逊——把开发 Claude 大语言模型的 Anthropic 公司告上加州北区联邦法院。他们指控说,Anthropic 偷偷从互联网上的两个盗版书库(LibGen 和 PiLiMi),下载了大约七百万本有版权保护的书,他们用这些书来训练 Claude。同时,Anthropic 还启动了一个破坏性扫描的“巴拿马计划”,把公司从各个旧书店购买的上百万册的纸质书籍拆散、扫描,然后销毁。这个案子审了一年之久,到了 2025 年 6 月,主审法官威廉·阿尔索普提出了判决意见,大意是:用电子书训练 AI 模型这件事本身,算是法律上允许的“合理使用”,但是,从盗版网站下载七百万本书,而且把盗版书长期存放在 Anthropic 的服务器里,那就构成了版权侵权。于是,法官把正式审判日期定在 2025 年 12 月。
眼看就要开庭对簿公堂,诉讼案双方突然在 2025 年 8 月达成和解。和解的条件是 Anthropic 必须把从 LibGen 和 PiLiMi 下载的盗版书的数据全部销毁,Anthropic 答应赔 15 亿美元,可能是美国史上最大一笔版权和解金。这笔和解金要分给 48 万多部著作的版权人,算下来,每本书能分到三千美元。这个案子立刻在出版界和 AI 行业引起巨大的震动。既然扫描整本书和建立搜索数据库是“合理使用”,那么用扫描出来的任何数字文本训练商用大语言模型,是不是也顺理成章?法律给出的答案是肯定的,这个判决的意义无疑超出了谷歌图书项目的诉讼案和 Anthropic 诉讼案本身。
如今,OpenAI、Anthropic、Meta 等公司的训练数据主要来自网络爬虫,它们从维基百科、新闻网站、学术期刊、开源代码库等众多网页抓取数字内容。《纽约时报》终于在 2023 年 12 月起诉 OpenAI 和微软,指控它们非法抓取数百万篇《纽约时报》的新闻报道,用以训练 ChatGPT。2026 年 7 月,就在我起草这篇文章期间,多家主流出版商和畅销书作家在纽约南区联邦地区法院,再次对谷歌提出集体诉讼,指控他们把用来搜索片段的图书扫描件,拿去训练大语言模型 Gemini。这一起诉讼可能是继 Anthropic 的 15 亿美元版权和解案之后,在 AI 版权领域最受关注的法律行动之一。
但法官的历次判决都说明,美国法院倾向于把训练 AI 大语言模型看作是对原作品的变革性使用,因此属于“合理使用”范畴。只有 AI 公司获取数据的方式,才可能触碰法律的红线,比如绕过反爬虫机制,无视网站的“机器人协议”(robots.txt),或从盗版网站下载受版权法保护的内容等做法。由于法官把“获取数据”和“使用数据”分割成两个独立的法律问题,AI 公司获得了“合理使用”数据的豁免,只会在“获取数据”的手段上,陷入盗版和侵权的麻烦。人类数千年所积累的公共知识,在这个法律的灰色地带,被巧妙地转化为私有模型的权重参数,然后再通过 API 以每千次调用的价格,回售给社会。
目前,学术出版已经变成重灾区。在北美学术系统中,学者投稿是免费、同行评审是免费,编辑也几乎是免费的,顶级的学术刊物从来不会牵涉到任何金钱交易,学术界也一直在遵守传统的学术公地(academic commons)的规范。但像爱思唯尔(Elsevier)这样的出版巨头竟占有学者无偿生产的学术内容和公共资金资助的科研成果,然后以高价再卖回给大学图书馆和公众。讽刺的是,爱思唯尔自己也是今年发动对谷歌起诉的原告之一,因为 AI 公司通过机构订阅和灰色渠道获取学术论文,用以训练自己的大语言模型,对爱思唯尔的利益造成了侵害。这种愈演愈烈的知识“寻租”和规模化的数字圈地,正在世界各个角落里发生,它们共同指向一个事实:知识的公共性正在被系统性瓦解,取而代之的是大数据被私有化,以及少数人对人类知识实行的资本垄断。
▍ 看不见的劳动:大语言模型生产链
面对日益加剧的知识垄断,很多人都在问,这究竟是资本主义发展的新阶段,还是某种前所未有的政治经济大转型?从经典马克思主义的理论看来,资本主义的基本矛盾是生产资料私有制和社会化大生产之间的矛盾。少数资本家拥有生产资料,包括工厂、机器和土地,而大批工人出卖劳动,以雇佣劳动换取工资,生产出来的剩余价值被资本家占有。不过,随着资本主义的发展和生产力的提高,生产资料进一步集中,生产社会化程度进一步提高,资本主义私有制往往转化为新的生产方式的桎梏。这一基本矛盾在数字知识垄断的新历史条件下,有没有变化?如果有,都有哪些变化?知识、数据、算法、数据中心、GPU 集群等都是当代数字经济的主要生产资料,这些生产资料归谁所有、受谁的支配或垄断?这些依然是最根本的问题,也是我们分析当代资本主义基本矛盾的起点。
在工业资本主义时代,工人作为雇佣劳动者,至少还有组织工会、争取八小时工作日的机会。在数字经济的形态下,随着生产社会化的幅度遍及全世界,几乎所有的人——不光是雇佣劳动阶级——都在为少数生产资料的占有者工作,而且在绝大多数情况下是做无偿的劳动。那么,这些人的劳动价值将如何计算?这是我们无法回避的问题。尤其是当硅谷科技巨头在第三世界——主要是讲英语的前殖民地非洲国家——大量使用外包公司榨取廉价劳动的时候(比如图像的数据标注、语言模型的人工训练,以及其他劳动密集型的人工操作),这种剥削就更加明显。对行外人来说,这个劳动大军根本不存在,几乎全部都被遮蔽,造成外界对 AI 的普遍误解。
一个著名的案例就是亚马逊公司的无人超市自动结账系统,藏在这个系统后面的是廉价印度工人。亚马逊雇用了上千名印度工人,从远程后台实时监控和标注顾客行为,从一万多公里以外进行遥控,让顾客相信无人超市是在“自动”结账。[4] 人类学家玛丽· 格雷和计算机科学家西达尔特·苏里给这一类做法起了一个生动的绰号,叫“幽灵工作”,指的是硅谷公司把人的智慧劳动伪装成 AI 智能,有些看似智能化的 AI 服务,实际上是靠隐藏在后台的人实时操作。格雷和苏里合作写过一本书,书名就叫《幽灵工作:如何制止硅谷创造一个新的全球底层阶级》。这本书已有中译本出版,但不知什么原因,译者把书名改成《销声匿迹:数字化工作的真正未来》。
其实,亚马逊公司从事这一类的幽灵工作已有 20 多年,早在 2005 年,它就推出一个叫 Amazon Mechanical Turk(MTurk)的众包劳务平台,把计算机不能自动完成而人能轻易完成的任务外包出去,即所谓“人类智能任务”,比如图像标注、文本分类、数据清洗、内容审核等。2007 年,计算机科学家李飞飞的团队惊喜地发现了 MTurk 这个众包劳务平台,就马上利用这个平台,招聘分布在全世界 167 个国家的 49000 多名数字工。这些数字工花了两年半的时间,标注了首批 320 万张图像,每一张图像都有高度准确的标签。他们用集体劳动和智慧创造了一个庞大的、分辨率极高的图像数据集。也就是说,AI 图像数据库和图像识别算法的第一次飞跃,是亚马逊的众包劳务平台 MTurk 成就的。李飞飞把这个图像数据库命名为 ImageNet。但凡 AI 领域的人都知道,ImageNet 大大推动了 AI 图像识别算法的前沿发展。[5]
ChatGPT 不是严格意义上的“幽灵工作”,但密集型人工劳动对训练和运行语言模型也同样不可或缺。很多使用 ChatGPT -4(或更高版本)的人,都惊叹于这个聊天机器所达到的智能水平,但他们所不知道的是,在 ChatGPT 后面有一条横跨全球南方(肯尼亚、印度、菲律宾、委内瑞拉等国)的人工劳动链条,从数据清洗、内容审核、图像标注、输出评估,到系统校准、人类反馈强化学习等等。
就拿人类反馈强化学习(RLHF)来说,这个环节对实现和改进大语言模型的“智能”十分关键。然而,它不能不依赖人工提供的密集型脑力劳动,根据工人对多重模型的回答排序(“哪个回答更好”等)产生的人类偏好数据,对模型的行为进行微调。而所谓数据清洗,实际上是通过人为加工,去除原始数据中的重复、纠正错误、剔除低质量内容;只有经过这一道人工清理步骤的数据,才能被拿来训练大语言模型。目前有很多研究表明,非洲的肯尼亚工人就从事了大量数据清洗和其他劳动。
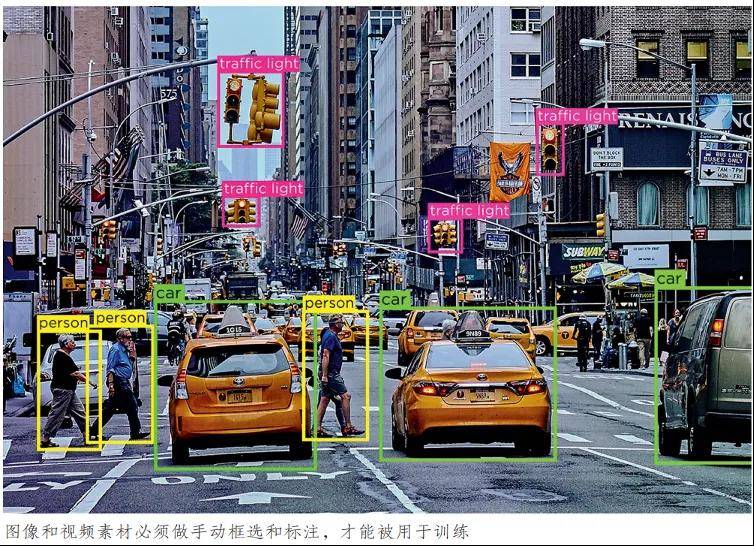
《AI 帝国》一书的作者郝珂灵采访了肯尼亚的数据工人,揭露了 OpenAI 开发团队如何通过外包公司撒马(Sama)雇用成千上万的当地工人,为 AI 模型进行图像及视频的识别与标注。比如,在自动驾驶领域,对视频素材中的每一辆车、每一位行人、每一个红绿灯、每一条车道线都必须做手动框选和标注,才能训练一个模型识别道路环境中的组件。不只如此,肯尼亚的数据工人在进行内容审核和信息过滤的环节中,同样要做大量的手工和脑力劳动。这里需要强调的是,工人做的不是简单的图像“标注”,而是在训练 AI 大语言模型如何识别和拒绝有害内容。这些肯尼亚工人的薪酬极低(时薪常低于 2 美元),但每天需要审核数千条文本和图像,有些文本和图像涉及儿童性虐待、暴力屠杀、极端仇恨言论等,这使有些工人遭受了严重的心理创伤。[6]
总之,知识垄断资本主义正在重塑劳动和资本的关系。它不仅表现在 AI 带来的经济转型的后果上,如大批人可能因此失业;事实上,许多人在日常生活中已在为 AI 创作内容、标注数据、测试模型,这种看不见的低薪劳动或无偿劳动,使得剥削具有了更深的隐蔽性。这种隐蔽性还有另一个特点:在通常情况下,无偿的用户劳动是在用户不知情的情况下发生的,比如验证算法输出(点击验证码、纠正翻译错误、评价回答质量)等。这些“数据工作者”中的大部分人,一边在劳动,一边不知道自己在劳动——任何人在互联网上发布一篇博客、一段代码、一张照片,写一篇评论,点一次赞,都在为科技巨头的模型提供免费的训练饲料。但是,这些平台绝不会主动地向你透露,将怎样利用你的信息和劳动成果;即使在法律的要求下透露一小点,面对长达数万字的用户协议,你也很难有讨价还价的余地。
所有这些劳动都属于 AI 科技公司的“隐形劳动供应链”。
无论是生产资料所有权的转移,还是 AI 公司的隐形劳动供应链,我们从谷歌的数字圈地和 OpenAI 公司对第三世界劳工的榨取中看得很清楚,数字知识的私有化不需要“篱笆”和“围墙”等物理手段就能完成;大语言模型的生产链被外包到第三世界,把廉价人工劳动隐匿在“智能”的光环之下。所有这一切用不着坚船利炮,仅依靠法律条款、用户协议、技术壁垒和商业模式就能做到。我在上文提到美国著作家协会的诉讼案,以及美国最高法院在 2016 年对谷歌图书项目“合法使用”的认可,都是如此。但这里还有一个更关键的环节我们不能忽略,那就是知识产权制度的建立和全球化。
▍ 知识垄断资本主义
阿根廷政治经济学家塞西莉亚·里卡普在《一切如常的资本主义?》一文中,把知识产权制度的全球化,追溯到 20 世纪 80 年代末。她发现,最早把数字时代的“知识”从计算机硬件里剥离出来的做法,出自 IBM 公司的一个销售策略,与 AI 无关。那时候的计算机数字技术虽然已经很发达,但 AI 尚未开始主导数字技术。IBM 之所以决定改变其销售策略,是因为他们想规避美国司法部的反垄断诉讼,同时也防止自己的竞争对手索赔。为此,他们做了一个决定:把计算机的软件和硬件分开销售,让法律保护的范围扩大到软件本身,这就是著名的为软件(代码、算法等)“解绑”的时刻。从那时起,美国通过一系列的法律和制度变革,逐步建立起一个更广泛的、可以覆盖数字技术的知识产权制度。其中最具有代表性的事件就是 20 世纪 90 年代中期制定的《与贸易有关的知识产权协定》(TRIPS)。[7]
一说到知识产权制度,人们往往肃然起敬,好像这是天经地义的存在,其实不然。
很多人都忽略了,以 TRIPS 为法律基础的当代知识产权制度的出现,与我们熟知的传统专利及版权保护法的制度——比如 BIRPI——大不相同。当代知识产权制度与新自由主义的经济全球化完全同步,并成为这个过程的关键推手。既然如此,我们是不是应该首先了解一下,这个新制度究竟是谁炮制的?为什么被炮制出来?这些问题必须提出来,因为它直接牵涉到跨国私营企业怎样参与了全球治理,并且开始发挥举足轻重的作用。
回看历史,这件事必须先从 TRIPS 说起,因为它是世界贸易组织(WTO)体系的一部分,任何加入世贸组织的成员都必须签署这个协定,包括中国。奇怪的是,这个国际协定的构思最初不是由美国政府或任何政府提出的,而是由 13 家跨国公司提出和推动的,包括 IBM、辉瑞公司、默克公司、惠普公司、杜邦公司、强生公司、孟山都公司、华纳通讯公司、通用电气和通用汽车公司等。正是这 13 家公司,分别作为制药、软件、娱乐、制造业等不同行业的代表,在 1986 年发起了一个名为“知识产权委员会”(IPC)的联盟组织。[8] 它们以在全球范围内推动知识产权——涵盖专利、版权、软件、数据库、商标和商业秘密——的保护为己任,并联合欧洲和日本的科技巨头拟订了一份提案。两年后,知识产权委员会把提案交给关税与贸易总协定(GATT)秘书处,这便是对后世产生极大影响的所谓《关税与贸易总协定中有关知识产权条款的基本框架》。
欧美日的跨国公司联合炮制的这一份知识产权国际规则的新蓝本,成为各国政府进行谈判和制定细则的制度雏形,也是后来世贸组织 TRIPS 的文本基础。这说明在新自由主义资本主义全球化的过程中,私营跨国公司的力量对国际政治施加了根本性的影响。最初由欧美日跨国公司提出的知识产权蓝图,经过多边谈判后,逐步被制度化、法律化,最后通过贸易制裁的机制强化执行。[9] 如今 TRIPS 已成为具有约束力的国际法,跨国公司终于在全球知识产权协定中,实现了它们的大部分诉求,把知识转化为企业最有价值的私有资产。这完全符合意大利经济学家乌戈·帕加诺所说的知识垄断资本主义——这种垄断不完全来自生产力的发展或市场创新的推动,而是主要来自跨国公司对知识的法律垄断。[10]
跨国公司的这种做法,让我想到马克思与恩格斯曾经在《共产党宣言》里分析过的 19 世纪资产阶级,但又有很大的区别。马克思与恩格斯早就注意到,从大工业和世界市场建立的时刻起,资产阶级就已经在代议制国家里取得了政治统治权,因此“现代的国家政权不过是管理整个资产阶级的共同事务的委员会罢了”[11]。用大白话说就是,大资本掌管了国家政权。因此从马克思主义的立场看来,西方民主国家政党的代表性问题,从一开始就不是实质性的问题。自 20 世纪 80 年代后期至 90 年代中期,新自由主义全球化又进一步扩展了大资本的势力范围。比如,上文中提到的那 13 家跨国公司为什么要带头成立“知识产权委员会”?恰恰是因为大资本已经不满足于掌管各自的国家政权,它们要把管理资产阶级共同事务的“委员会”推广到全世界,最终导致冷战后许多国家政权的性质和建构出现了重重危机。这是从我自己的观察和分析中得出的一个结论。如果这个结论成立的话,那我们就必须重新思考以 TRIPS 为法律基础的知识产权制度出台后的垄断资本主义,以及当代垄断资本主义与 19 世纪的资本主义之间究竟有哪些本质上的区别。
相关辩论正在世界各地如火如荼地展开,我不可能在一篇文章里做详细的介绍和评述。例如,经济学家雅尼斯·瓦鲁法基斯最近在他的论著中断言,资本主义已经终结。他给出的理由是,硅谷科技巨头变成了类似封建王国的领主,它们是数字平台的“云封建主”,而依附于平台的人变成了“云农奴”等等。瓦鲁法基斯从一连串类比出发的论述,乍一看有道理,但仔细一琢磨,问题就来了:瓦鲁法基斯是不是把不同层次的事物混淆在一起了?[12] 在我看来,用类比的修辞去替代概念分析,用“技术封建主义”去概括当代垄断资本主义,这样得出的结论不能不是印象式的、肤浅的和误导的。相比之下,我倒是认为,从对数字知识垄断的批判出发,才能深化我们对当代资本主义的认识。
▍ 保护数字知识公地
一个幽灵,AI 社会主义的幽灵,正在跨国资本主义中间游荡。硅谷科技巨头和所有代理它们的势力——美国谷歌、OpenAI、Anthropic,美国白宫、国会以及它们在全世界的傀儡们——为了驱除这个幽灵,正在结成不那么神圣的同盟。
说实在的,哪一个呼吁数字共享、保护数字公地的人不被骂为小偷、盗版者,或 AI 模型的知识“蒸馏”犯呢?[13] 在今天,难道我们还看不出来,那些骂别人的人,自己才是小偷,而且已经干了无数的非法数字圈地和知识蒸馏的勾当?硅谷科技巨头喜欢唱知识产权的高调,但那不过是为了捍卫它们通过不正当手段获得数据库和特权而已。
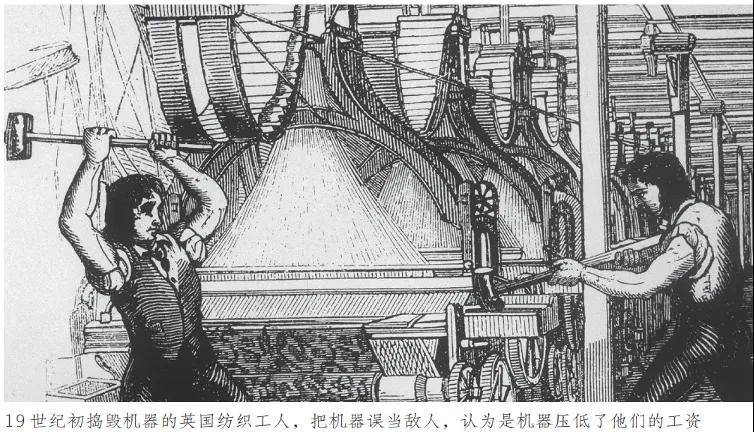
读过《共产党宣言》的读者,对上面两段话会觉得很熟悉,一点不错,它们的确是模仿了《共产党宣言》开头的语言。我只是把马克思和恩格斯的话做了一点改动,挪到了今天 AI 科技的语境里。在这样做的时候,我自己也很吃惊,发现马克思和恩格斯在 1848 年说的话,竟然一点也不过时。他们对 19 世纪资本主义的精辟分析,非但不过时,在今天仍然不失其思想力度。譬如,马克思当年对卢德派(Luddites)的思考,在当下也需要我们回顾,值得我们借鉴。卢德派指的是在 19 世纪初捣毁机器的英国纺织工人,这些工人把机器误当敌人,认为机器压低了他们的工资,导致他们大批失业。所以,马克思在《资本论》第一卷中说:“工人学会把机器和机器的资本应用区别开来,学会把他们的攻击对象从物质的生产工具,转向生产工具的使用方式,这是需要时间和经验的。”[14]
不过,只要技术发明被资本利用,任何时候都可能出现卢德派,任何时候都会有人跳出来和机器作对。不过,今天的卢德派未必会去砸机器,也未必是工厂里的产业工人。在当代,围绕着生成式 AI 技术的普遍焦虑是,一旦通用人工智能(AGI)变成现实,机器必将超越人类,就连被誉为“AI 教父”的杰弗里·辛顿也以他的方式加入了“卢德派”的行列。几年前,辛顿毅然辞去谷歌副总裁的职位,向世人发出警告:生成式 AI 技术如果照现在的速度发展下去,不仅会造成大批人失业,还会危及人类文明。他举例说,AI 制造的文本和图像会让人真假不辨、是非不分,导致社会伦理的全面崩溃。在 2024 年底 BBC 广播电台的一次采访中,他竟开出了人类文明灭绝的时间表,表示他有 10%~20% 的把握,AI 不出 30 年就会摧毁人类文明。一年后,他在拉斯维加斯的 Ai4 会议上修正了自己的预测,把灾难降临的时间提前到 5 年至 20 年。然而,事实上,辛顿的末日预言一出,所有 AI 公司的股价应声大涨,华尔街的投资人都赚得盆满钵满。这不禁让人想起弗雷德里克·詹姆逊的一句名言,有些人“想象世界的末日,比想象资本主义的末日要来得更容易”[15]。
2026 年上半年,微软公司旗下的 Open AI 向美国证监会(SEC)提交了保密 S-1 招股书,据说由高盛和摩根士丹利担任承销商,私募估值接近 8520 亿美元,今年年底或 2027 年初就能上市。差不多在同一时间,Anthropic 也提交了保密 S-1 招股书,据称私募估值高达 9650 亿美元。它说明了什么?说明 AI 金融化的前景无比诱人,所以 AI 公司的 CEO 个个都要争当弗兰肯斯坦博士的角色。[16] 可问题是,华尔街的投资人为什么争先恐后地要给毁灭人类文明的 AI 公司投资呢?这里的逻辑当然不可告人,秘而不宣。
也许,我们需要一部新的科幻小说,书名叫《华尔街的弗兰肯斯坦》。
在这部当代版的小说里,故事的核心并不在技术本身,而在人的灵魂;故事的情节也不是人类文明的末日,而是垄断资本主义最终的归宿。华尔街的弗兰肯斯坦——我们新版故事里的主人公——并不是直接从 AI 实验室走出来的,而是依靠数字圈地和对知识产权的垄断跻身于世界舞台。和今日当红的科技巨头一样,他走到哪里都打着技术创新的旗号,实行的却是金融资本对数据、模型、算力、租金的开发和收割,是典型的知识垄断资本主义。
从法律和制度上的安排来看,现世的知识垄断资本主义实行了双重占有:一方面,AI 大公司,尤其是 OpenAI、Anthropic 和谷歌,在“合理使用”的法律保护下,大肆盗取公共知识,然后用这些免费知识训练大语言模型;另一方面,这些公司通过知识产权法和商业秘密法,把自己的算法专利、模型权重、训练数据等作为公司的核心资产保护起来。到目前为止,所有法律诉讼案都显示,硅谷科技巨头的“使用权”受到法律严格保护,而公共领域和个人创造的知识,则被它们自由取用。正是在法律的保护伞之下,知识垄断资本主义才能实现“对社会知识的不断攫取;正是凭借这种攫取,垄断者才得以支配其他企业和组织。当今的资本积累,在很大程度上正是由掠夺行为以及无形资产的资产化所驱动和维系的”[17]。
从上文所述,我们可以清楚地看到,当代 AI 公司的资本积累靠的是数字圈地,靠的是用算法收割数字知识公地。而“圈地”一旦完成,“收割”就进入另一个阶段:用户必须给应用程序编程接口(API)付费,他们买的不是平台创造的知识,而是由平台提供的“通行权”,这就把 AI 公司变成马克思所说的“食利者”(rentier)。举一个最普通的例子,假如我想下载我自己写的书的电子版,我必须向某个平台付费,缴纳“租金”。即使我能免费从大学图书馆那里下载,但大学图书馆同样要按年给“订阅”的数字平台交租金。我们可以说,在这样的数字经济中,用户和平台之间发生的交易不一定与商品买卖有关,而在多数情况下,用户是在给平台资本家交“地租”。
我此处说的“地租”不完全是隐喻,而是有具体所指。马克思在《资本论》第三卷里对“资本主义地租的产生”的研究,对解释当代资本如何实行知识产权的垄断,仍具有重要意义。在马克思的分析中,地租是土地所有者凭借对土地的垄断而获得的收入,但他把地租分为劳动地租、实物地租和货币地租等几种不同形式。在生产力低下的情况下,劳动地租和实物地租是剩余价值或剩余劳动唯一流行和正常的形态;在资本主义历史条件下,实物地租即向货币地租转换,而这个转换是以商业、城市工业和商品生产比较发达,货币流通获得显著发展为基础的。货币地租是资本主义的产物,不是封建主义的产物,恰恰是因为它克服了封建地租——劳动地租和实物地租——中的人身依附关系和超经济的强制性劳动,才能转化成资本主义超额利润的地租,同时造就马克思所说的“食利者”资本家。
在今天的数字经济中,货币地租和与其相关的金融衍生产品比以往任何时代都发达,它们都在直接推动知识垄断资本主义的发展。这尤其表现在,作为新一代的“食利者”,平台资本家为了巩固自身“坐地收租”的领先地位,必须在与对手竞争的过程中,给数字基础设施大举投资,并持续投入研发(R&D)。我们以硅谷科技巨头 2025 年和 2026 年的研发数据为例。Meta 在 2025 年的研发投入达 574 亿美元,较 2024 年增长 31%。仅 2026 年第一季度,Meta 的研发支出就达 177 亿美元,同比增长 46%,全年可能超过 650 亿美元。Alphabet(谷歌)2025 年研发支出是 611 亿美元,今年第一个季度约 170 亿美元。亚马逊的“技术与基础设施”费用在 2024 年为 885 亿美元,2025 年为 1085 亿美元。微软 2025 年的研发支出约为 325 亿美元,预计 2026 年将达到约 356 亿美元。苹果的研发预算增速最快,公司在 2025 年支出约 329 亿美元,今年第一季度首次实现季度研发支出突破 100 亿美元,在第二季度创下 114 亿美元的纪录,同比增长 34%。[18] 这些公司在研发上的巨额投入,是为了确保自己永久性的垄断优势,包括对数字无形资产进行持续采集、传输、存储的特权,榨取隐形劳动以及它们自己“坐地收租”的特权。
需要申明的是,我此处说的“坐地收租”,意思很明确——用户是在给垄断平台的资本家“交租”,而不是给封建领主交租;因此,虽然也“交租”,可谈不上有什么“平台封建主义”。马克思在《资本论》第三卷研究的“货币地租”就属于资本主义地租之列。列宁在马克思论述的基础上,对金融资本做了进一步的研究。他在《帝国主义论》这本重要著作中提出,货币资本一旦从工业资本中分离出来,就创造出少数的完全靠货币资本收益为生的“食利者”。这些食利者是在从企业家和所有直接参与资本经营的人中间分离出来以后,才变成金融资本的主宰者。列宁写道:“帝国主义,或者说金融资本的统治,是资本主义的最高阶段,这时候,这种分离达到了极大的程度。金融资本对其他一切形式的资本的优势,意味着食利者和金融寡头占统治地位,意味着少数拥有金融‘实力’的国家处于和其余一切国家不同的特殊地位。”[19] 今天再读这个段落,是不是感觉列宁描述的时代,很像我们这个时代?这里唯一的不同是,金融资本和数字知识垄断已经结合起来,而且有迹象显示,这种结合会变得越来越牢固。
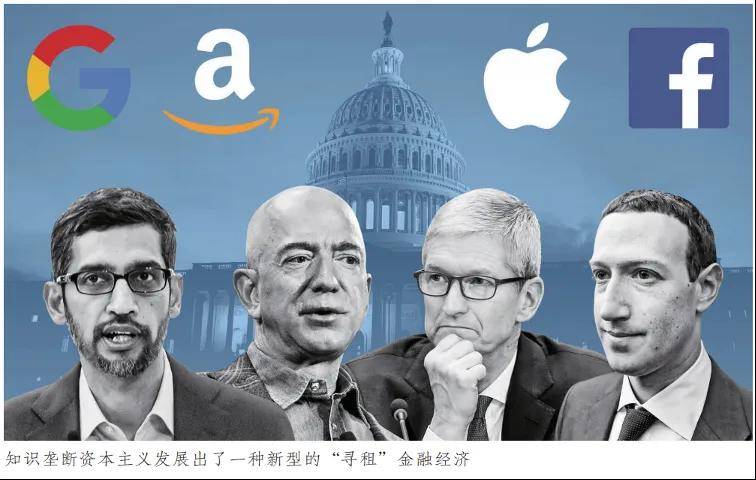
在我们的数字时代,知识垄断资本主义发展出了一种新型的“寻租”金融经济。硅谷的 AI 公司凭借其对训练数据、算力基础设施和模型权重的垄断,其经济规模已经非常惊人。前文提到 OpenAI 和 Anthropic 这两个公司准备上市的巨额估值,这些估值的底层资产主要还不是办公楼、服务器或数据中心,而是被压缩进模型参数中的几千年的人类知识积累的成果。然而放眼世界,我们看到的是少数科技寡头站在了 AI 技术的最前沿,可世界上绝大多数国家、机构和个人只能作为消费者或 API 调用者、数据提供方、无偿或低价劳动力存在。
知识垄断资本主义是人类唯一的出路吗?
▍ AI 社会主义
从密歇根大学图书馆的秘密扫描室,到遍布全球的 AI 数据中心,历时 20 多年的数字圈地运动已经彻底改变了人类知识的生产和流通方式。今天,我们站在一个历史的岔路口,前面出现两条路:一条路通向知识垄断资本主义的进一步深化,少数科技巨头垄断人工智能,大多数人沦为数据劳工;另一条路则通向 AI 社会主义的探索、知识公地的保护、人工智能技术的民主化,以及用全球的多方合作代替零和竞争。
让我们发挥一下想象力:假如世界上最重要的 AI 模型不是由 OpenAI 或谷歌的董事会控制,而是由国际合作机构来管理;假如训练数据来自全球共享的公共知识库,而不被秘密抓取和私人垄断;如果算力资源像电力一样,作为公共基础设施进行分配,而不是集中在少数科技巨头的数据中心,那么,AI 是不是有可能成为解放生产力的工具,而不是加剧人与人不平等的枷锁?
这一愿景并非空中楼阁。
首先,保护数字知识公地、坚持开源模型、促进全球协作的呼声越来越高,正在成为世界各国人民的共识。联合国教科文组织在 2021 年发布的《开放科学建议书》中,呼吁投资建设数据公地和全球知识公地,结合开放教育资源(OER)和开放获取(open access),提出向开放知识实践的公共基础设施转型,包括存储、管理和数据公地的科学服务与研究基础设施。其次,如何监管 AI 的开发,如何治理 AI 等问题,已经变得日益尖锐。各国都在纷纷出台 AI 的监管框架,比如中国 2023 年颁布的《生成式人工智能服务管理暂行办法》和欧盟 2024 年出台的《人工智能法案》。最后,在技术层面上,DeepSeek-R1 和 Kimi-K3 的出色表现,说明 AI 系统开源模型的协作开发是可以和商业闭源模型竞争的。DeepSeek 以极低的成本,训练出高性能的推理模型,恰恰得益于开源社区多年积累的技术知识,这些知识是全球研究者共同创造的公共资源。
我在这篇文章里提出“AI 社会主义”,不是说要用 AI 管理计划经济(当然这也是一个值得探讨的话题),而是说应该把 AI 的生产资料和生产方式,包括数据、模型、算法、算力等,开放给大多数人,不再受金融寡头所垄断。这意味着什么呢?它意味着各级政府需要统筹 AI 基础研究,加大对其投入,并监督它的使用。但有人可能出来反驳:政府介入 AI 研究符合经济规律吗?它难道不会扼杀科技的创新?我可以用事实来回答这个问题。
美国联邦政府一直是 AI 基础研究的大金主。凯特·克劳福德的著作《人工智能图谱:权力、政治与人工智能的全球成本》显示,人工智能研究从一开始就是美国国防和军事情报部门投入巨额资金——纳税人的钱——培育出来的,也就是说,AI 不是从大学实验室里自然生长出来的中立技术。从 1956 年美国海军研究办公室(ONR)给达特茅斯会议提供的研究经费,到美国国防高级研究计划局(DARPA)前二十年垄断性的高科技投入,再到谷歌和 Palantir 的 Project Maven(算法战跨职能小组)大规模监视系统的开发,联邦政府资助的这条脉络就没有中断过。[20] DARPA 前主任罗伯特·斯普劳尔自己承认,“整整一代计算机专家都是 DARPA 资助起步的”,并且“80 年代中期第五代(先进计算)项目中的所有构想——人工智能、并行计算、语音理解、自然语言编程——追根溯源,都是来自 DARPA 资助的研究”。[21]
既然如此,与其放任硅谷的私营科技巨头收割全民资助的 AI 成果,为什么不可以把这些生产资料和生产方式还给纳税人,开发出真正符合公众利益和服务于公众的 AI 技术?虽然这个总体目标在美国很难实现,但欧盟和中国已经开始探索这个路径,比如欧盟通过“欧洲共同利益重要项目”(IPCEI)为 AI 基础设施提供公共资金;中国把“开源共享”作为国家战略发展 AI,推动建设国家公共数据资源平台;等等。这些都是正在实现的目标。
此外,保护知识公地的运动也在世界各地蓬勃展开,集中在以下几个方面。一是建设公共 AI 基础设施。政府和国际组织投资建设公共算力中心和公共数据集,有点类似于高速公路和国家电网的投资。AI 基础设施作为全社会经济活动的基础,不应该让私营科技巨头垄断。欧盟的 Gaia-X 云基础设施项目、法国的 Jean Zay 超级计算机、英国的生物样本库(UK Biobank)就是在这个方向做出的初步尝试。二是建立数据信托和数据合作社,让数据生产者集体管理自己的数据,分享 AI 系统使用这些数据所产生的收益。在这方面,瑞士的 MIDATA 和西班牙的 Salus Coop,都提供了有益的参考。三是建立全球知识公地宪章。以国际公约的方式,明确数字知识公地的边界和保护机制,比如限制商业 AI 公司对公共领域内容的排他性使用,确认图书馆、档案馆和博物馆的数字化藏品都属于公共文化资产,确保 AI 训练数据的透明度和可审计性,等等。
什么是知识公地?在过去的 20 年中,这方面的理论和实践都给我们提供了大量的参考。夏洛特·赫斯、埃莉诺·奥斯特罗姆在《将知识理解为公地:从理论到实践》一书中,提出知识不是静态和孤立的东西,而是一个复杂的生态系统。从本质上来说,知识是一种共享资源,不是市场交易的对象。一个人的使用并不会减少另一个人的使用,因此,知识资源是非竞争性的。知识的生产、流通和使用总是发生在特定的社群关系和制度安排之中,知识公地的核心困境不在于过度使用,而是供给不足和获取障碍的问题。假如知识产权过度扩张,到处筑起不可逾越的技术壁垒,那它必然妨碍知识的创造、流通和分享。所谓“公地”,不是无人管理的免费资源,而是一个制度化的,通过规则、规范和实践来协调的分享机制。在这方面,数字知识提供了前所未有的信息获取渠道。
知识公地不是乌托邦式的幻想。事实上,创造和捍卫知识公地的机制建设已经有很多成功的案例,比如 Linux 开源软件运动、维基百科和开放获取学术出版。维基百科是全球最大的免费在线百科全书,内容全部由志愿者协作编写,形成了从普通编辑到管理员、仲裁委员会,自下而上的信任与授权体系。还有类似维基百科的开放数据公地,比如 OpenStreetMap,志愿者在这里协作绘制和编辑世界地图,已经被联合国、人道主义组织和商业公司广泛使用。2010 年海地地震后,六百名 OpenStreetMap 志愿者在三个星期内就绘制出了太子港的详细地图,其响应速度超过了所有商业和政府机构,体现出数字公地在危机中的突出作用。
越来越多的大学和研究资助机构,目前都要求所有接受其资助的个人和机构,必须让自己的学术成果开放获取,这就为知识公地提供了制度上的支持。比如 GenBank,这是美国国立卫生研究院(NIH)下属的核酸序列数据库,生物学家可以在这里免费提交和获取基因数据,数据共享已经从自愿行为转变为学科规范,建设出一片生物学的公共科学公地。美国大学的开放教育资源实验也已经实行了 20 多年,麻省理工学院的 OpenCourseWare 在 2002 年启动后,几乎所有的课程材料都免费上网,这方面的例子还很多。此外,数字知识公地还可以通过 Creative Commons 许可协议、开放获取出版,以及公共领域承诺(CC0)等工具得到开发和保护。
虽然数字知识公地的开发有了很多成功的例子,但我们不能低估实现 AI 社会主义目标的困难。第一个困难就是算力的集中。训练前沿大语言模型需要数以万计的高端 GPU,而全球绝大部分先进芯片由英伟达生产,且受到美国出口管制,因此,算力不仅是技术问题,还涉及地缘政治问题。当算力被少数国家和公司垄断时,AI 的民主化就无从谈起。何况,即使模型权重是开源的,没有足够算力的国家、机构和个人仍然无法参与 AI 的开发和部署。
第二个困难是数据在事实上的不平等。我在最近出版的一本书中强调,全球互联网和大语言模型的内容以“全球英文”为主导,但世界上数千种语言的数据极度稀缺,其中一半以上的语言正濒临灭绝。[22] 用计算机学科——自然语言处理(NLP)领域——内部的术语来描述,就是高资源语言和低资源语言之间的分别。从 AI 中获益最多的,往往是拥有丰富数字资源的语言群体,而不是那些被数字资源边缘化的群体。AI 社会主义若要实现,就不能忽视低资源语言的处境,因为数据的不平等也会转化为社会智能的不平等。
不过,还有一个更大的现实困难,是地缘政治驱动的科技竞争。目前 AI 被当作国家战略竞争力的核心,美国、中国、欧盟都在争夺 AI 主导权。在这种背景下,开源模型与闭源模型之争往往被扭曲为国与国之间的技术竞赛。美国出于所谓“国家安全”的需要下达芯片禁令,DeepSeek 的崛起被西方媒体说成是中国的“斯普特尼克时刻”,全都是这种竞争的表现。从本质上说,开源模型其实是跨国界的一种技术合作形式,在大国博弈的紧张局势中,这种技术合作具有多重意义,其中之一,是防止 AI 被完全武器化。
在当前形势下,维护开源模型的公共性显得尤为紧迫,已经成为保护知识公地的前沿。近来,DeepSeek 的 R1 和 V4 Pro 以及月之暗面 Kimi K3 的成功,为全球各地的研究者和开发者在本地部署、微调和改进模型提供了新的可能。这样的开源路线不仅能追赶闭源巨头,还能在特定领域实现超越。中国与东盟国家的 AI 开源联盟、LMOS 开源 AI 代理平台,以及 Hugging Face 等模型托管平台,都有望携手共建模型开源、算力共享、语料共建、标准互通的 AI 生态系统。
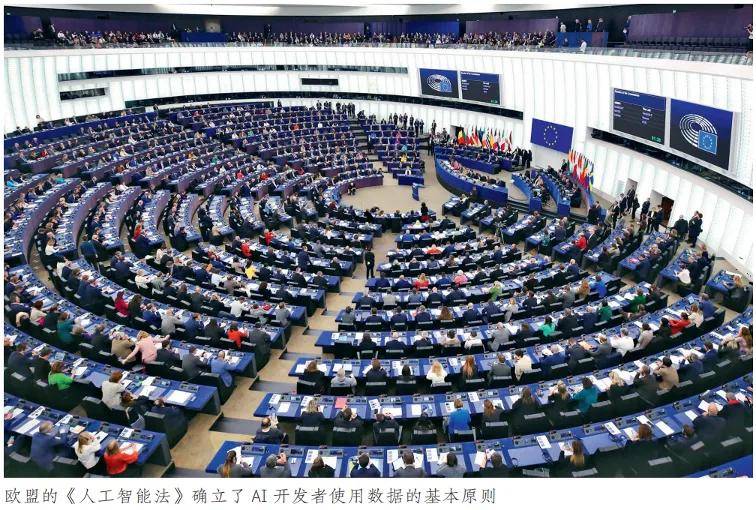
无论采取什么方案去解决上述困难,最终的决定不取决于技术本身,而取决于人们的政治意志和制度创新。欧盟的《人工智能法》要求 AI 开发者披露训练数据来源、尊重版权退出机制、记录数据溯源信息。虽然这一法规主要针对商业 AI 系统,并试图在促进创新和保护创作者权益之间寻找平衡,但它确立了一个重要原则:训练数据不是“无主荒地”,不能让科技巨头将它随便圈走。最后,我要强调的一点是,AI 系统的治理不能仅由技术专家和董事会来决定,还必须纳入广泛的公众意见和参与。比如,一个公共 AI 模型的训练目标、安全准则和应用边界该如何设定?到底是让追求利润最大化的科技公司来设定,还是由代表不同利益的社会群体和部门来审议决定?我想答案是很清楚的。
数字知识公地属于全人类,AI 社会主义绝不是空想。
编辑 |王尧池、RJX
注释(向上滑动查看)
[1] 参见Kim Clarke, “It Happened at Michigan-Digitizing the University Library,” The Record, University of Michigan, July 22, 2024。
[2] 有关“技术封建主义”和《新左派评论》杂志上发表的争论,参见 Joel Kotkin, The Coming of Neo-Feudalism: A Warning to the Global Middle Class, Encounter Books, 2020;Cédric Durand, Techno-f éodalisme: Critique del’ économie numérique, Zones, 2020;Evgeny Morozov,“Critique of Techno-Feudal Reason,” New Left Review, No. II/133 (January–February), 2022, pp. 89~126。
[3] 原告律师团队获得了一亿多美元的巨额报酬。有关细节参见 Order Granting Final Approval of Class Action Settlement, Bartz v. Anthropic, PBC, No. 3:24-cv-05417-AMO, Dkt. 680 (N.D. Cal., July 20, 2026)。
[4] Haleluya Hadero,“Amazon Removed Just Walk Out from Many of its Own Stores but Wants to Sell the System to Others,” Associated Press, April 18, 2024.
[5] 参见Mary L. Gray and Siddharth Suri, Ghost Work: How to Stop Silicon Valley from Building a New Global Underclass, Houghton Mifflin Harcourt, 2019,作者论述亚马逊众包劳务平台和李飞飞的研究在第一章。
[6] 参见Karen Hao, Empire of AI: Dreams and Nightmares in Sam Altman’ s OpenAI, Penguin Press, 2025,相关论述在第九章。
[7] Cecilia Rikap,“Capitalism as Usual? Implications of Digital Intellectual Monopolies,” New Left Review, No. II/139 (January–February), 2023, pp. 148~149.
[8] 详见哈格利博物馆与图书馆(Hagley Museum and Library),“Intellectual Property Committee Records”,档案入藏号:2492。
[9] Susan K. Sell, Private Power, Public Law: The Globalization of Intellectual Property Rights, Cambridge University Press, 2003
[10] Ugo Pagano,“The Crisis of Intellectual Monopoly Capitalism,” Cambridge Journal of Economics, Vol. 38, No. 6, 2014, pp. 1409~1429.
[11] 马克思、恩格斯:《共产党宣言》,载《马克思恩格斯选集》第 1 卷,中共中央马克思恩格斯列宁斯大林著作编译局译,人民出版社 2012 年版,第 402 页。
[12] Yanis Varoufakis, Technofeudalism: What Killed Capitalism, Melville House Publishing, 2024.
[13] 模型蒸馏(distillation)是让小模型效法大模型的思维方式,实现又快又便宜的 AI 部署,这是 AI 行业通行的做法,OpenAI、Google、Anthropic都做过蒸馏模型。现在西方用“蒸馏术”指责DeepSeek 和 Kimi,指控它们用西方模型的公开接口,违反服务条款的方式,蒸馏硅谷公司研发的模型。
[14] 译文由本文作者根据英文版翻译,见 Karl Marx, Capital: A Critique of Political Economy, Vol. 1, Book One: The Process of Production of Capital, translated by Samuel Moore and Edward Aveling, edited by Frederick Engels, Progress Publishers, 1867。
[15] Fredric Jameson, An American Utopia: Dual Power and the Universal Army, Verso, 2016.
[16]《弗兰肯斯坦》是英国作家玛丽·雪莱(Mary Shelley)的著名科幻小说。主人公弗兰肯斯坦博士在实验室创造了一个怪物,结果追悔莫及,因为他无法控制自己制造的怪物。
[17] Cecilia Rikap,“Capitalism as Usual? Implications of Digital Intellectual Monopolies,” New Left Review, No. II/139 (January–February ), 2023, p. 159.
[18] 数据来自美国证交会(SEC)官方数据库,参见Meta Platforms, Inc., Form 10K annual report for fiscal year ended December 31, 2025 (SEC Accession No. 000162828026003942), U.S. Securities and Exchange Commission., 2026;以及 Amazon、Alphabet、Apple、Microsoft 在同一数据库中的财报与披露文件。
[19] 列宁:《帝国主义是资本主义的最高阶段》,中共中央马克思恩格斯列宁斯大林著作编译局译,人民出版社 2014 年版,第 56 页。
[20] 这方面有大量的研究,如 Paul N. Edwards. The Closed World: Computers and the Politics of Discourse in Cold War America, MIT Press, 1996; Linda Weiss, America Inc.? Innovation and Enterprise in the National Security State, Cornell University Press, 2014。
[21] Kate Crawford, Atlas of AI: Power, Politics, and the Planetary Costs of Artificial Intelligence, Yale University Press, 2021, p. 184. 中文译本将书名改作《技术之外:社会联结中的人工智能》。
[22] Lydia H. Liu, Anupama Rao, and Charlotte Silverman, eds., Global Language Justice, Columbia University Press, 2023.
本文原载于《文化纵横》2026年10月刊,仅代表作者观点,供读者参考。
 相关文章
 头条焦点


 精彩导读
 关注我们
【查看完整讨论话题】 | 【用户登录】 | 【用户注册】